Profil kandydata na szablonie firmy - bez przepisywania i bez zmyślania
Jeśli pracujesz w rekrutacji, znasz ten moment: kandydat jest dobry, klient czeka, a Ty od godziny przenosisz jego CV na firmowy szablon. Kopiujesz doświadczenie, poprawiasz wcięcia, usuwasz telefon i adres, sprawdzasz, czy daty się zgadzają. Potem następne CV, w zupełnie innym układzie.
Przez ostatnie miesiące budowałem system, który robi to za rekrutera - dla firmy rekrutacyjnej, na jej szablonie i jej prawdziwych profilach. Ten wpis ma dwie części. Pierwsza jest dla osób z rekrutacji: co ten system robi i czego celowo nie robi. Druga jest dla technicznych: jak jest zbudowany i dlaczego tak.
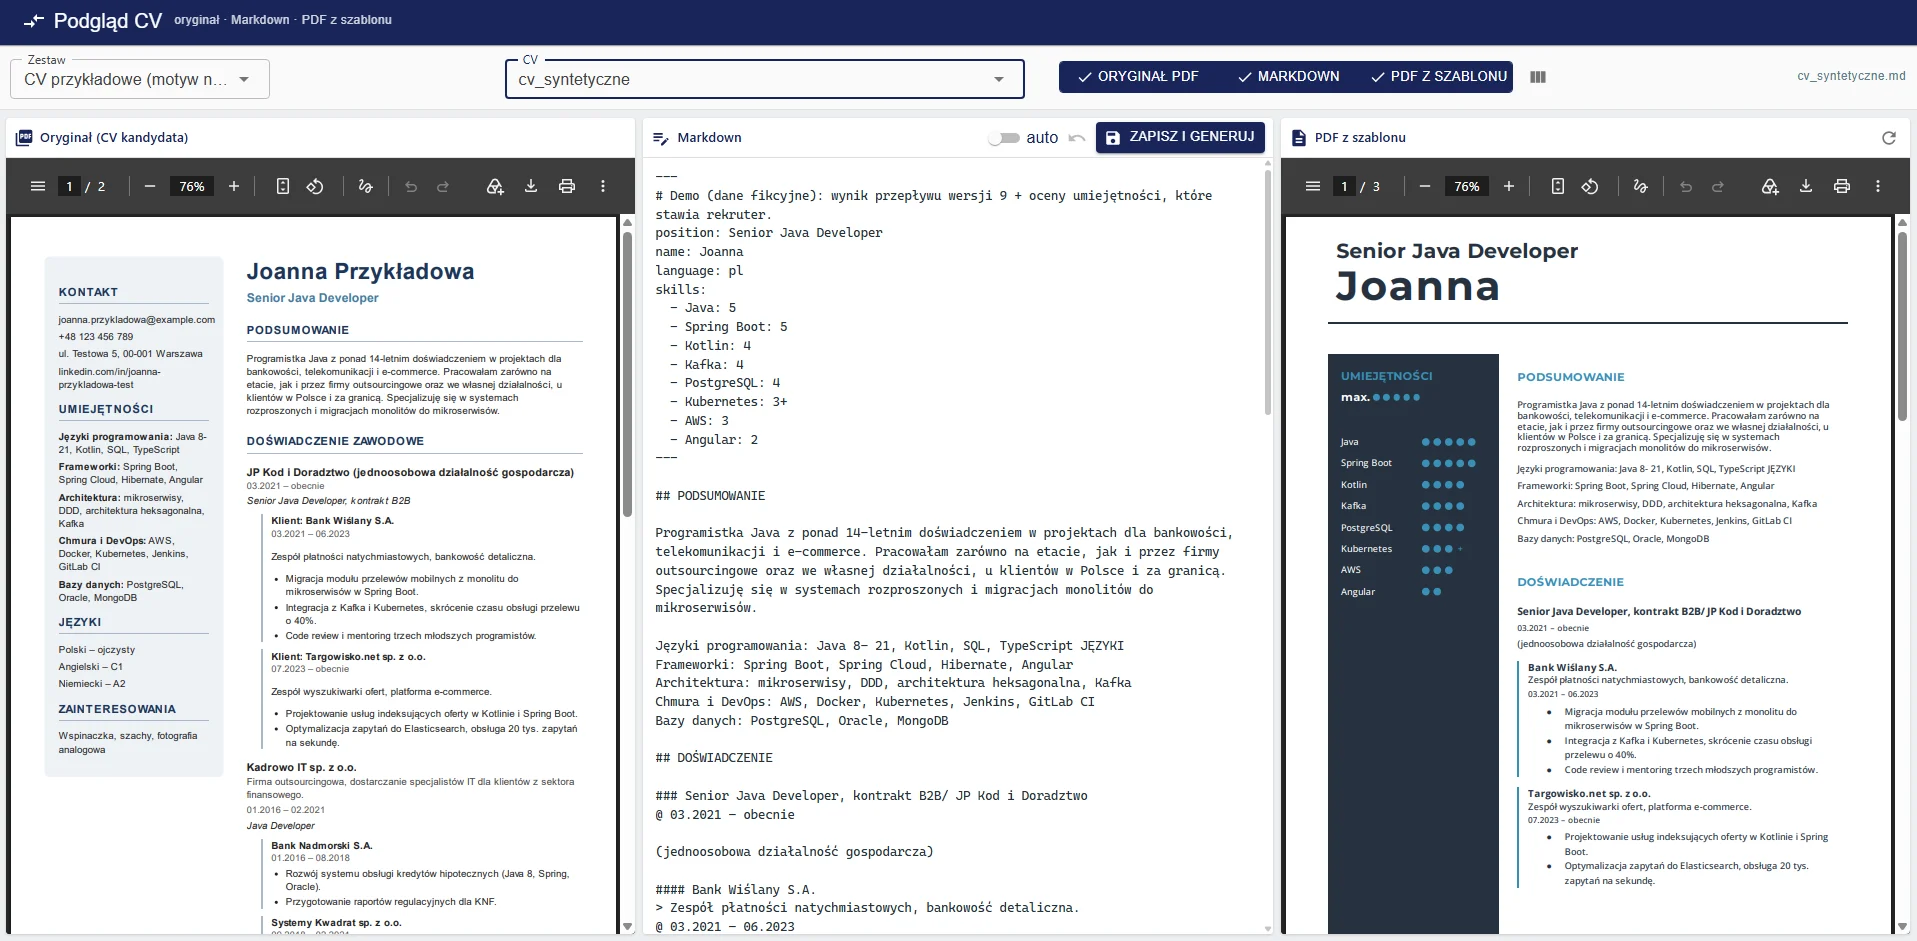
Po lewej oryginał CV, w środku tekst profilu, po prawej gotowy PDF na szablonie. Kandydat jest fikcyjny.
Część 1. Dla rekrutera
To nie jest automat, który wysyła profile za Ciebie
Najczęstsza obawa, jaką słyszę: „AI zrobi profil, a ja nawet nie będę wiedzieć, co w nim jest”. Ten system działa odwrotnie. Przygotowuje szkic, a Ty go sprawdzasz i zatwierdzasz. Różnica polega na tym, że zamiast przepisywać całe CV, oglądasz gotowy profil obok oryginału i poprawiasz to, co chcesz zmienić.
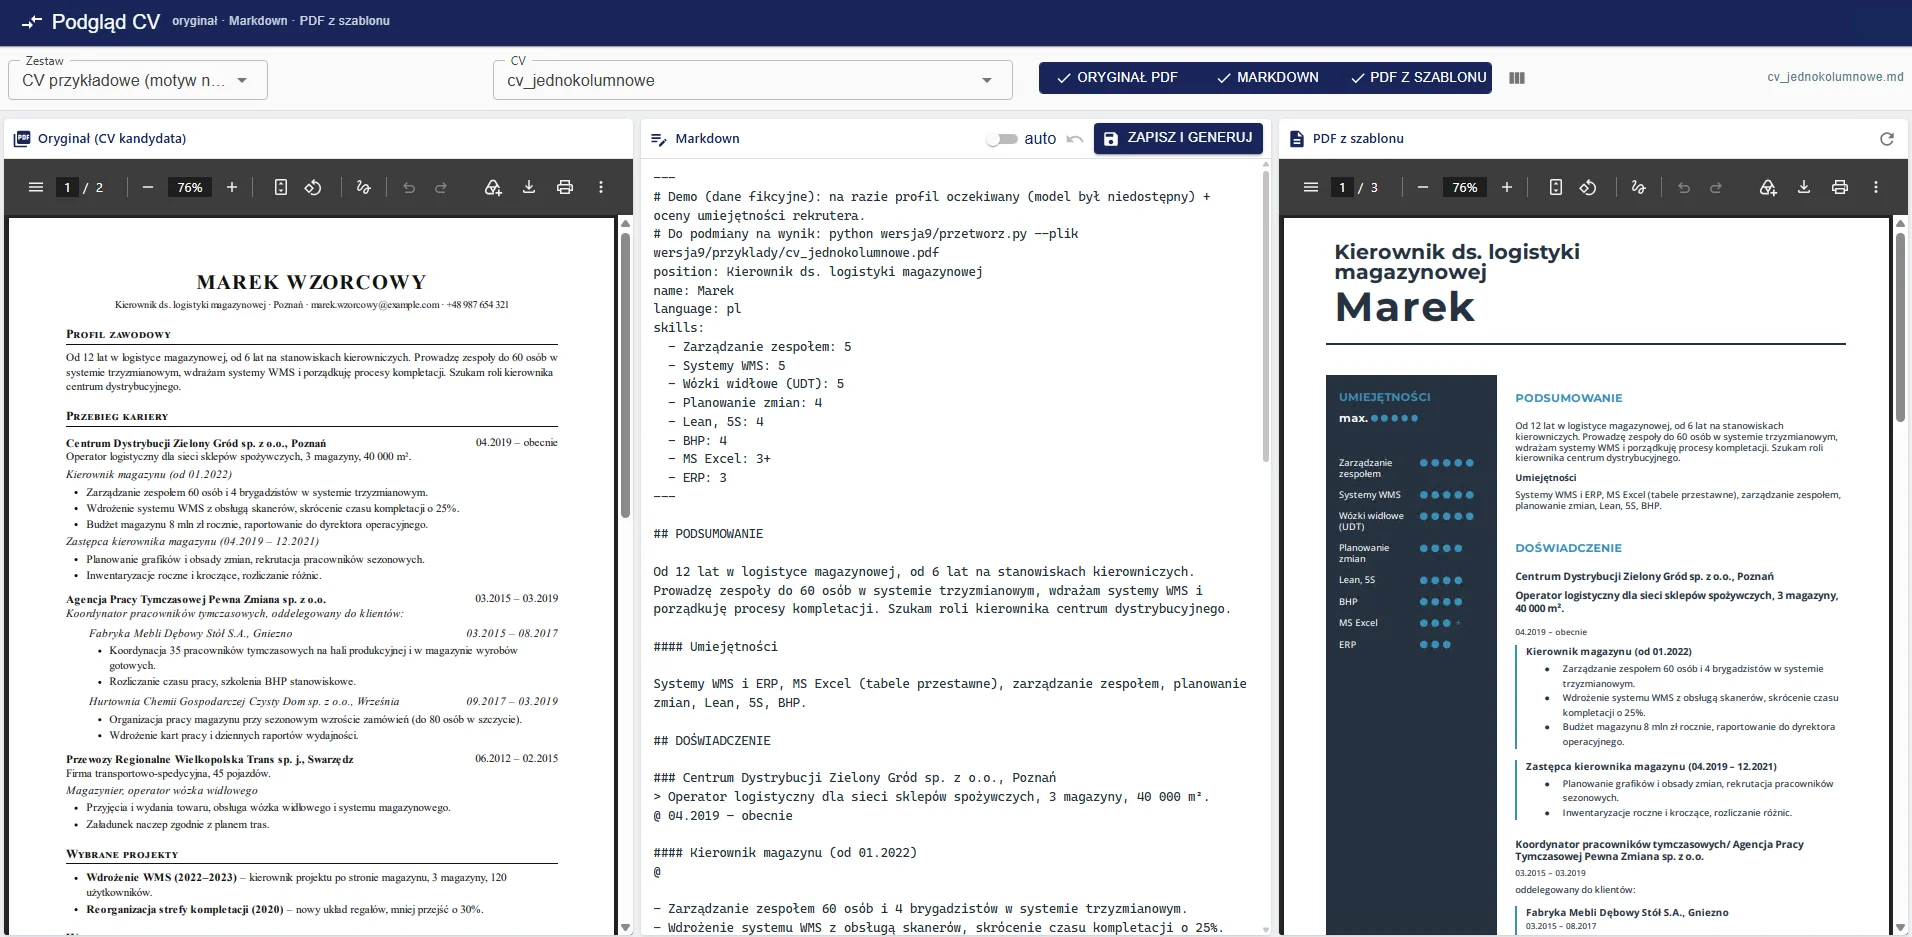
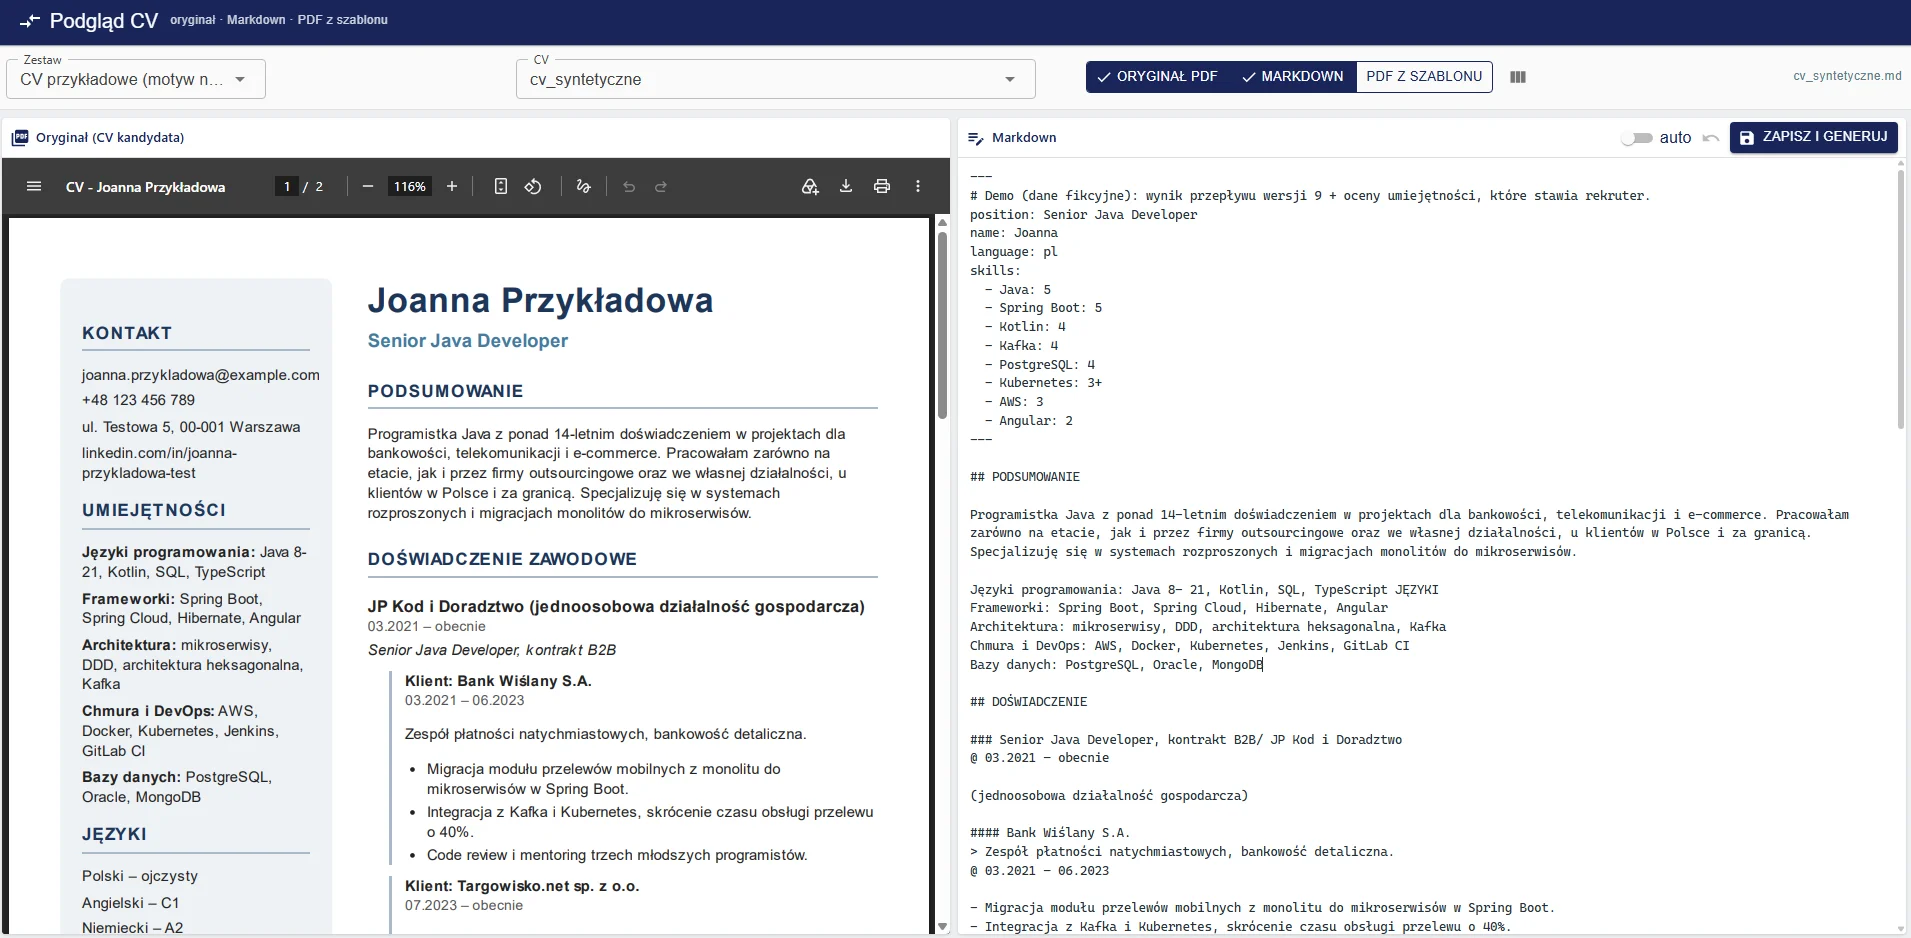
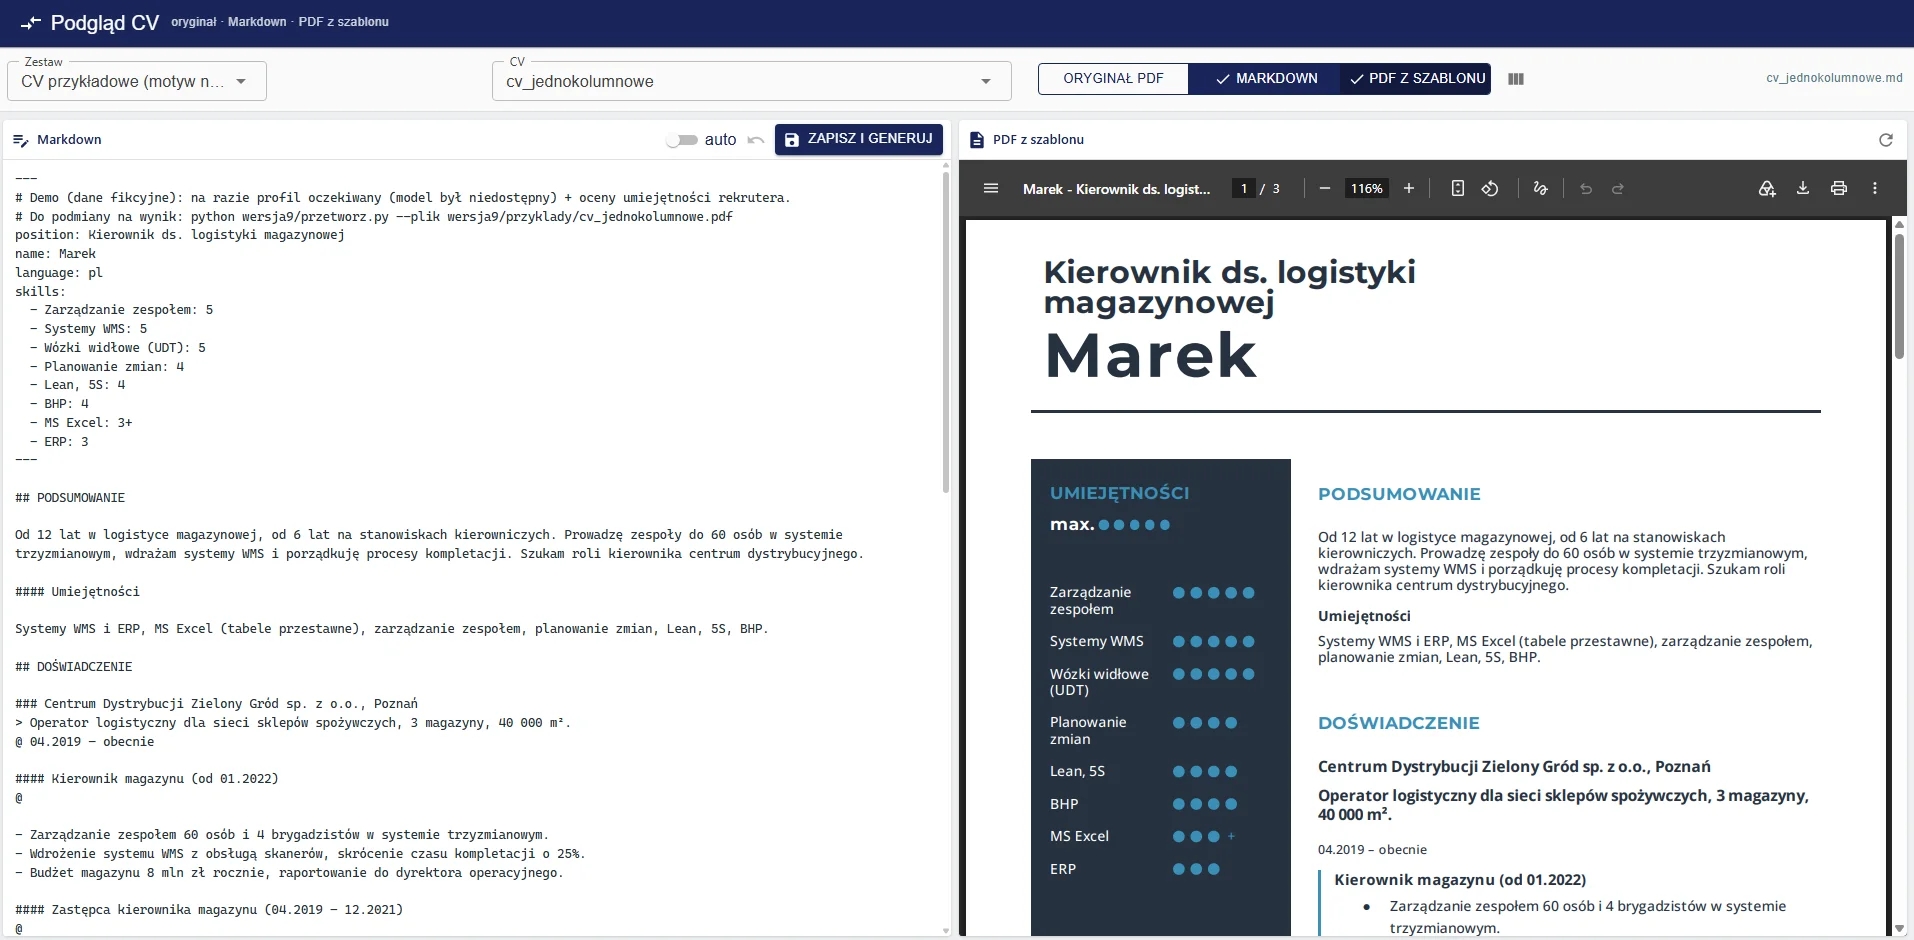
Na ekranie masz trzy panele: oryginał kandydata, tekst profilu do edycji i PDF na Waszym szablonie. Poprawiasz tekst, klikasz „Zapisz i generuj”, po kilku sekundach masz nowy PDF. Formatowanie robi się samo.
Treść 1:1 - nic dopisanego, nic poprawionego
To jest najważniejsza zasada całego projektu. Profil musi mówić dokładnie to, co napisał kandydat:
- daty, nazwy firm i stanowiska przechodzą bez zmian - także wtedy, gdy kandydat zrobił literówkę,
- żadna umiejętność nie pojawia się znikąd - jeśli nie ma jej w CV, nie ma jej w profilu,
- nic nie ginie - system sprawdza, czy każda linia oryginału trafiła do profilu albo została pominięta z konkretnego powodu (np. to był numer telefonu).
Dlaczego to takie ważne? Bo zwykły czat AI pisze ładnie, ale nie wiernie. Skraca, „poprawia” i dopowiada. Profil czyta się świetnie, aż kandydat na rozmowie z klientem zapyta, skąd w jego CV technologia, której nigdy nie używał. Wtedy wstyd ma rekruter, nie model.
Dane kandydata nie wychodzą z firmy
CV to dane osobowe. Zgoda kandydata na przetwarzanie danych przez Waszą firmę nie oznacza zgody na wysłanie jego CV do ChatGPT czy innej chmury za oceanem. Dlatego:
- model językowy działa lokalnie - na komputerze w sieci firmy, a nie w zewnętrznej usłudze,
- nazwisko, telefon, e-mail, adres i linki znikają, zanim model w ogóle zobaczy tekst,
- jeśli coś się przecieknie, przetwarzanie się zatrzymuje - profil z danymi kontaktowymi nie powstanie,
- na gotowym profilu zostaje samo imię, tak jak klient zwykle je dostaje.
W testach na prawdziwych CV: zero przecieków danych osobowych.
Co zostaje dla Ciebie
Celowo, nie z braku możliwości:
- oceny umiejętności (kropki 1-5 na pasku) - to Twoja ocena kandydata, nie informacja z dokumentu, więc system ich nie zgaduje,
- stanowisko, pod które idzie profil,
- wybór, co skrócić pod konkretną ofertę,
- ostatnie spojrzenie przed wysyłką.
Krótko: system robi przepisywanie, Ty robisz rekrutację.
Czy to może działać u Was?
Szablon dopasowujemy do wyglądu Waszych obecnych profili: logo, kolory, fonty, kolejność sekcji, klauzula RODO w stopce, wersja polska i angielska. Opis produktu, zrzuty i sposób startu: CV kandydata na szablonie Waszej firmy.
Jeśli przepisujecie CV ręcznie i chcecie zobaczyć to na swoim szablonie, napiszcie: michal@agidot.eu albo zadzwońcie: +48 574 200 802.
Część 2. Dla technicznych
Dalej jest o tym, jak to jest zbudowane. Dłuższy opis samej wierności tekstu (głosowanie źródeł, liczby z korpusu) jest w osobnym wpisie: AI, które nie ma prawa zmyślać.
Przebieg
CV (PDF / DOC / DOCX)
  -> [0] Word -> PDF (LibreOffice)
  -> [1] odczyt: warstwa tekstowa PDF + obraz strony
  -> [2] przepisanie przez model lokalny (kolejność czytania)
  -> [3] uzgodnienie z warstwą tekstową (znaki z PDF-a, nie z modelu)
  -> [4] anonimizacja
  -> brama: przeciek danych osobowych = stop
  -> [5] struktura: model zwraca bloki JSON, kod przypina każdy do linii źródła
  -> [5b] skład według reguł firmy (nazwy i kolejność sekcji)
  -> [6] walidacja 1:1: pokrycie linii, daty, wpisy
  -> [7] przywrócenie imienia
  -> [8] render szablonu do PDF
Model to Qwen3-VL 30B-A3B na llama-server, na stacji z GPU w sieci lokalnej. Klient modelu jest na bibliotece standardowej Pythona, a odpowiedzi modelu są zapamiętywane po skrócie polecenia i treści, więc powtórny przebieg tego samego CV trwa sekundy.
Rozdzielenie ról: znaki z pliku, kolejność z modelu
Warstwa tekstowa PDF-a jest wierna znakowo, ale przy dwóch kolumnach albo pasku bocznym gubi kolejność - data jednej roli ląduje przy innym pracodawcy. Model widzący obraz strony dobrze odtwarza kolejność, ale nie jest wierny znakowo: poprawia literówki i ujednolica nazwy. Dlatego kolejność bierzemy z modelu, a znaki z warstwy tekstowej. Model nigdy nie jest ostatnim źródłem tego, jaki znak jest na kartce.
Model przypisuje, nie pisze
W etapie struktury model nie dostaje polecenia „napisz sekcję doświadczenie”. Dostaje wierny tekst i ma go rozłożyć na bloki: sekcja, wpis (stanowisko, firma, okres, opis firmy), podtytuł, punkt. Kod przypina każdy blok do konkretnej linii źródła. Linie, których model nie oddał, wracają obok sąsiada i są zaznaczone do sprawdzenia. Kontakt, klauzula RODO czy „Miasto, data” wypadają z profilu z zapisanym powodem.
Po tym etapie działa walidacja deterministyczna: czy każda linia źródła jest w profilu albo ma powód pominięcia, czy wszystkie daty przeszły, czy nie pojawił się ciąg znaków, którego nie ma w oryginale. To porównanie łańcuchów - tanie i przewidywalne, w przeciwieństwie do drugiego modelu w roli sędziego.
Anonimizacja przed modelem
Dane osobowe są wykrywane i zastępowane tokenami, zanim tekst trafi do etapu struktury. Wykrywanie łączy reguły (e-mail, telefon, kod pocztowy, linki) z heurystykami układu, np. imię i nazwisko jako największa czcionka na pierwszej stronie, także rozbite na dwie linie, albo wartość po etykiecie „Imię i nazwisko:”. Model może wskazać kandydata na dane osobowe, ale tylko taki, który dosłownie występuje w tekście, a podmianę robi kod. Za anonimizacją stoi brama: jeśli w tekście zostało cokolwiek z listy danych osobowych, przebieg się zatrzymuje. Po składzie przywracane jest wyłącznie imię.
Gotcha warta zapamiętania: model widzący nieprzezroczyste tokeny w miejscu danych uznawał je za „brak danych” i gubił całe pola. Trzeba mu wprost powiedzieć, czym są tokeny.
Format pośredni: ścisły Markdown
Wynikiem nie jest od razu PDF, tylko Markdown z określoną gramatyką: nagłówek YAML (stanowisko, imię, język, umiejętności z ocenami 1-5), ## sekcja, ### wpis, > opis firmy, @ okres, #### podtytuł, listy. Praca przez pośrednika (outsourcing, B2B, software house) to wpis pośrednika z klientami jako wpisami podrzędnymi - tak samo awans w jednej firmie.
Parser jest celowo nietolerancyjny: przy dwuznaczności rzuca błąd z numerem linii zamiast zgadywać. Ten sam model danych zapisuje się do Markdown i JSON w obie strony i ma schemat JSON Schema. Dzięki temu rekruter edytuje treść, a nie układ, i nie może go przypadkiem zepsuć.
Render i wygląd firmy
Markdown -> HTML -> PDF przez Chromium (Playwright), z fontami lokalnie, więc render działa bez internetu. Wygląd firmy siedzi w jednym pliku motywu (motyw.yaml + logo): kolory, fonty, format A4 albo Letter, nagłówek, pasek boczny, stopka. Reguły składu (nazwy sekcji po polsku i angielsku, kolejność, gdzie idą umiejętności) są osobno, per firma.
Aplikacja do przeglądu
Panel ze zrzutów to .NET 10, Blazor Server i MudBlazor. Trzy panele w dowolnej kombinacji, edycja Markdowna, Ctrl+S zapisuje i generuje nowy PDF. To tu odbywa się praca człowieka w pętli.
Wyniki i ograniczenia
Na CV spoza zestawu, na którym system był strojony (PDF, DOC i DOCX): 0 przecieków danych osobowych, 395 dat w źródłach i 0 zgubionych, 0 zgubionych linii. W porównaniu z profilami, które dla tych samych kandydatów zrobił człowiek, 35 z 42 wpisów doświadczenia trafiło w parę. Czas bez udziału człowieka: od około pół minuty do kilku minut na CV.
Uczciwie o tym, co jeszcze nie działa idealnie:
- etap struktury bywa leniwy (pomija linie) albo się zapętla - kod dokłada brakujące linie, ale ich miejsce trzeba obejrzeć,
- nagłówek sekcji z paska bocznego potrafi zginąć przy przepisaniu i wtedy treść trafia do złej sekcji,
- skany bez warstwy tekstowej są na razie pomijane.
Dlatego człowiek w pętli nie jest tu ozdobnikiem dla uspokojenia klienta. Jest częścią architektury.
Jeśli budujecie coś podobnego dla dokumentów, w których nie wolno zmienić ani słowa - umów, polis, protokołów - te same zasady działają poza rekrutacją. Chętnie porozmawiam: michal@agidot.eu.